IA remodelează lumea și, în același timp, inventează un limbaj cu totul nou pentru a descrie modul în care face acest lucru. Participă la orice întâlnire de produs, prezentare sau masă rotundă din zilele noastre și vei auzi oamenii vorbind despre LLM-uri, RAG, RLHF — și, începând de săptămâna trecută, termeni precum „recurență opacă”, tehnica de raționament din noul model Astra al OpenAI care a stârnit cercetătorii din domeniul siguranței IA-ului. Vocabularul evoluează atât de repede încât chiar și oamenii foarte inteligenți din lumea tehnologiei se simt puțin nesiguri.
Acest glosar reprezintă încercarea noastră de a remedia această situație: definiții în limbaj simplu ale termenilor din domeniul IA pe care îi veți întâlni cel mai probabil, indiferent dacă lucrați cu aceste tehnologii, investiți în ele sau pur și simplu încercați să țineți pasul citind TechCrunch sau ascultând podcasturi pe această temă. Îl actualizăm periodic, pe măsură ce domeniul evoluează, așa că considerați-l un document viu, la fel ca sistemele de IA pe care le descrie.
Inteligența artificială generală, sau AGI, este un termen vag. Dar, în general, se referă la o IA care este mai capabilă decât un om obișnuit în multe, dacă nu chiar în majoritatea sarcinilor. Sam Altman, CEO-ul OpenAI, a descris odată AGI-ul ca fiind „echivalentul unui om mediu pe care l-ai putea angaja ca coleg de muncă”. În același timp, carta OpenAI definește AGI ca fiind „sisteme extrem de autonome care depășesc performanțele oamenilor în majoritatea activităților cu valoare economică ridicată”. Viziunea Google DeepMind diferă ușor de aceste două definiții; laboratorul consideră AGI ca fiind „o IA care este cel puțin la fel de capabilă ca oamenii în majoritatea sarcinilor cognitive”. Sunteți confuzi? Nu vă faceți griji — la fel sunt și experții din prima linie a cercetării în domeniul IA.
Un agent IA se referă la un instrument care utilizează tehnologii de IA pentru a îndeplini o serie de sarcini în numele dvs. — dincolo de ceea ce ar putea face un chatbot IA mai simplu — cum ar fi înregistrarea cheltuielilor, rezervarea biletelor sau a unei mese la un restaurant, sau chiar scrierea și întreținerea codului. Cu toate acestea, așa cum am am explicat anterior, există multe elemente în mișcare în acest domeniu emergent, așa că „agent IA” poate însemna lucruri diferite pentru diferite persoane. De asemenea, infrastructura este încă în curs de dezvoltare pentru a-și îndeplini capacitățile prevăzute. Dar conceptul de bază implică un sistem autonom care poate apela la mai multe sisteme de IA pentru a îndeplini sarcini cu mai mulți pași.
Gândiți-vă la punctele finale API ca la niște „butoane” aflate în spatele unui program software, pe care alte programe le pot apăsa pentru a-l determina să execute anumite acțiuni. Dezvoltatorii folosesc aceste interfețe pentru a crea integrări — de exemplu, permițând unei aplicații să extragă date dintr-o altă aplicație sau facilitând controlul direct al serviciilor terțe de către un agent IA, fără ca un om să opereze manual fiecare interfață. Majoritatea dispozitivelor inteligente pentru casă și a platformelor conectate dispun de aceste butoane ascunse, chiar dacă utilizatorii obișnuiți nu le văd și nu interacționează niciodată cu ele. Pe măsură ce agenții de IA devin din ce în ce mai capabili, aceștia sunt tot mai în măsură să găsească și să utilizeze singuri aceste puncte finale, deschizând posibilități puternice — și uneori neașteptate — de automatizare.
La o întrebare simplă, creierul uman poate răspunde fără să se gândească prea mult — întrebări de genul „care animal este mai înalt, o girafă sau o pisică?”. Dar, în multe cazuri, ai nevoie adesea de hârtie și creion pentru a găsi răspunsul corect, deoarece există pași intermediari. De exemplu, dacă un fermier are găini și vaci, iar împreună au 40 de capete și 120 de picioare, s-ar putea să fie nevoie să scrii o ecuație simplă pentru a ajunge la răspuns (20 de găini și 20 de vaci).
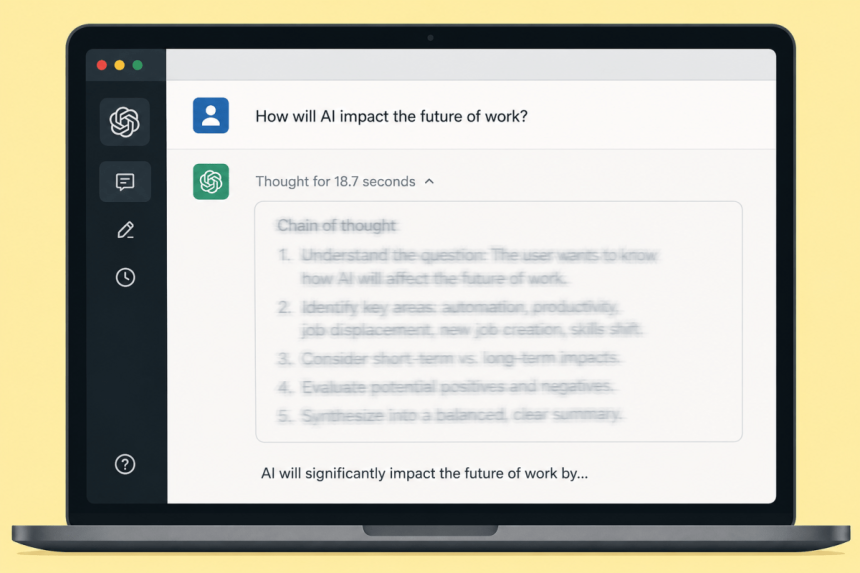
În contextul IA, raționamentul de tip „lanț de gândire” pentru modelele lingvistice de mari dimensiuni înseamnă descompunerea unei probleme în pași intermediari mai mici, pentru a îmbunătăți calitatea rezultatului final. De obicei, obținerea unui răspuns durează mai mult, dar este mai probabil ca răspunsul să fie corect, mai ales într-un context de logică sau de programare. Modelele de raționament sunt dezvoltate pornind de la modelele lingvistice mari tradiționale și optimizate pentru gândirea în lanț de gânduri datorită învățării prin întărire.
(Vezi: Model lingvistic mare)
Acesta este un concept mai specific decât cel de „agent IA”, care se referă la un program capabil să întreprindă acțiuni pe cont propriu, pas cu pas, pentru a atinge un obiectiv. Un agent de programare este o versiune specializată aplicată dezvoltării de software. În loc să sugereze pur și simplu cod pe care un om să îl revizuiască și să îl insereze, un agent de programare poate scrie, testa și depana codul în mod autonom, ocupându-se de genul de muncă iterativă, bazată pe încercări și erori, care de obicei ocupă întreaga zi a unui dezvoltator. Acești agenți pot opera pe întreaga bază de cod, identificând erori, rulând teste și implementând remedieri cu o supraveghere umană minimă. Gândiți-vă la asta ca la angajarea unui stagiar foarte rapid, care nu doarme niciodată și nu-și pierde niciodată concentrarea — deși, la fel ca în cazul oricărui stagiar, un om trebuie totuși să revizuiască munca.
Deși este un termen oarecum polivalent, „compute” se referă, în general, la puterea de calcul esențială care permite modelelor de IA să funcționeze. Acest tip de procesare alimentează industria IA, oferindu-i capacitatea de a antrena și de a implementa modelele sale puternice. Termenul este adesea o prescurtare pentru tipurile de hardware care furnizează puterea de calcul — componente precum GPU-urile, CPU-urile, TPU-urile și alte forme de infrastructură care constituie fundamentul industriei moderne a IA.
Un subset al învățării automate cu auto-îmbunătățire, în care algoritmii de IA sunt proiectați cu o structură de rețea neuronală artificială (ANN) multistratificată. Acest lucru le permite să realizeze corelații mai complexe în comparație cu sistemele mai simple bazate pe învățarea automată, precum modelele liniare sau arborii de decizie. Structura algoritmilor de învățare profundă se inspiră din căile interconectate ale neuronilor din creierul uman.
Modelele de IA bazate pe învățarea profundă sunt capabile să identifice singure caracteristicile importante din date, fără a mai fi nevoie ca inginerii umani să definească aceste caracteristici. Structura susține, de asemenea, algoritmi care pot învăța din erori și, printr-un proces de repetare și ajustare, își pot îmbunătăți propriile rezultate. Cu toate acestea, sistemele de învățare profundă necesită un număr mare de puncte de date pentru a obține rezultate bune (milioane sau mai mult). De asemenea, antrenarea lor durează de obicei mai mult în comparație cu algoritmii mai simpli de învățare automată — astfel încât costurile de dezvoltare tind să fie mai ridicate.
(Vezi: Rețea neuronală)
Difuzia este tehnologia care stă la baza multor modele de IA care generează artă, muzică și text. Inspirate de fizică, sistemele de difuzie „distrug” treptat structura datelor — de exemplu, fotografii, melodii și așa mai departe — prin adăugarea de zgomot până când nu mai rămâne nimic. În fizică, difuzia este spontană și ireversibilă — zahărul difuzat în cafea nu poate fi readus la forma de cub. Însă sistemele de difuzie din IA urmăresc să învețe un fel de proces de „difuzie inversă” pentru a restabili datele distruse, dobândind capacitatea de a recupera datele din zgomot.
Distilarea este o tehnică utilizată pentru a extrage cunoștințe dintr-un model de IA de mari dimensiuni, folosind un model de tip „profesor-elev”. Dezvoltatorii trimit solicitări către un model-profesor și înregistrează rezultatele. Răspunsurile sunt uneori comparate cu un set de date pentru a vedea cât de precise sunt. Aceste rezultate sunt apoi folosite pentru a antrena modelul-elev, care este antrenat să aproximeze comportamentul modelului-profesor.
Distilarea poate fi utilizată pentru a crea un model mai mic și mai eficient pe baza unui model mai mare, cu o pierdere minimă prin distilare. Probabil că așa a dezvoltat OpenAI GPT-4 Turbo, o versiune mai rapidă a GPT-4.
Deși toate companiile din domeniul IA utilizează distilarea la nivel intern, este posibil ca unele dintre ele să o fi folosit și pentru a ajunge la nivelul modelelor de ultimă generație. Distilarea de la un concurent, de obicei încalcă termenii și condițiile de utilizare ale API-urilor de IA și ale asistenților de chat.
Aceasta se referă la antrenarea suplimentară a unui model de IA pentru a optimiza performanța într-o sarcină sau un domeniu mai specific decât cel care a constituit anterior punctul central al antrenării sale — de obicei prin introducerea de date noi, specializate (adică orientate către o anumită sarcină).
Multe startup-uri din domeniul IA utilizează modelele lingvistice de mari dimensiuni ca punct de plecare pentru a crea un produs comercial, dar se străduiesc să sporească utilitatea pentru un sector sau o sarcină țintă, completând ciclurile de antrenare anterioare cu o ajustare fină bazată pe propriile cunoștințe și expertiză specifice domeniului.
(Vezi: Model lingvistic de mari dimensiuni [LLM])
O rețea GAN (Generative Adversarial Network) este un tip de cadru de învățare automată care stă la baza unor dezvoltări importante în domeniul IA generative în ceea ce privește producerea de date realiste — inclusiv (dar nu numai) instrumentele de tip deepfake. Rețelele GAN implică utilizarea unei perechi de rețele neuronale, dintre care una se bazează pe datele sale de antrenament pentru a genera un rezultat care este transmis celuilalt model în vederea evaluării.
Cele două modele sunt, în esență, programate să încerce să se întreacă reciproc. Generatorul încearcă să-și facă rezultatul să treacă de discriminator, în timp ce discriminatorul se străduiește să identifice datele generate artificial. Această competiție structurată poate optimiza rezultatele IA pentru a fi mai realiste, fără a fi nevoie de o intervenție umană suplimentară. Deși rețelele GAN funcționează cel mai bine pentru aplicații mai restrânse (cum ar fi producerea de fotografii sau videoclipuri realiste), mai degrabă decât pentru IA de uz general.
„Halucinația” este termenul preferat al industriei IA pentru modelele de IA care inventează lucruri — generând, literalmente, informații incorecte. Evident, aceasta reprezintă o problemă majoră pentru calitatea IA.
Halucinațiile generează rezultate ale GenAI care pot fi înșelătoare și ar putea duce chiar la riscuri în viața reală — cu consecințe potențial periculoase (gândiți-vă la o întrebare legată de sănătate care oferă sfaturi medicale dăunătoare).
Se consideră că problema IA-urilor care inventează informații apare ca urmare a lacunelor din datele de antrenare. Halucinațiile contribuie la o tendință către modele de IA din ce în ce mai specializate și/sau verticale — adică IA-uri specifice unui domeniu care necesită o expertiză mai restrânsă — ca o modalitate de a reduce probabilitatea lacunelor de cunoștințe și de a diminua riscurile de dezinformare.
Inferența este procesul de rulare a unui model de IA. Înseamnă a lăsa modelul să funcționeze pentru a face predicții sau a trage concluzii pe baza datelor analizate anterior. Pentru a fi clar, inferența nu poate avea loc fără antrenare; un model trebuie să învețe tiparele dintr-un set de date înainte de a putea extrapola în mod eficient din aceste date de antrenare.
Multe tipuri de hardware pot efectua inferența, de la procesoarele smartphone-urilor la GPU-uri puternice și până la acceleratoare de IA proiectate special. Dar nu toate pot rula modelele la fel de bine. Modelele foarte mari ar avea nevoie de o perioadă foarte lungă de timp pentru a face predicții, de exemplu, pe un laptop, comparativ cu un server cloud dotat cu cipuri de IA de ultimă generație.
[See: Training]
Modelele lingvistice de mari dimensiuni, sau LLM-urile, sunt modelele de IA utilizate de asistenții AI populari, precum ChatGPT, Claude, Gemini de la Google, Llama, IA de la Meta, Microsoft Copilot, sau Le Chat de la Mistral. Când discutați cu un asistent AI, interacționați cu un model lingvistic de mari dimensiuni care procesează solicitarea dvs. direct sau cu ajutorul diferitelor instrumente disponibile, cum ar fi navigarea pe web sau interpretoarele de cod.
Modelele lingvistice de mare anvergură (LLM) sunt rețele neuronale profunde alcătuite din miliarde de parametri numerici (sau ponderi, vezi mai jos) care învață relațiile dintre cuvinte și expresii și creează o reprezentare a limbajului, un fel de hartă multidimensională a cuvintelor.
Aceste modele sunt create prin codificarea tiparelor pe care le identifică în miliarde de cărți, articole și transcrieri. Când introduceți o solicitare într-un LLM, modelul generează tiparul cel mai probabil care se potrivește cu solicitarea.
(Vezi: Rețea neuronală)
Cache-ul de memorie se referă la un proces important care îmbunătățește inferența (adică procesul prin care IA funcționează pentru a genera un răspuns la interogarea unui utilizator). În esență, stocarea în cache este o tehnică de optimizare, concepută pentru a face inferența mai eficientă. IA este, evident, bazată pe calcule matematice extrem de complexe, iar de fiecare dată când aceste calcule sunt efectuate, ele consumă mai multă energie. Stocarea în cache este concepută pentru a reduce numărul de calcule pe care un model ar putea fi nevoit să le execute, salvând anumite calcule pentru interogările și operațiunile viitoare ale utilizatorilor. Există diferite tipuri de stocare în cache a memoriei, deși una dintre cele mai cunoscute este stocarea în cache KV (sau cheie-valoare). Cachingul KV funcționează în modelele bazate pe transformatoare și sporește eficiența, generând rezultate mai rapide prin reducerea timpului (și a efortului algoritmic) necesar pentru a genera răspunsuri la întrebările utilizatorilor.
(Vezi: Inferență)
Model Context Protocol, sau MCP, este un standard deschis care permite modelelor de IA să se conecteze la instrumente și date externe — fișierele, bazele de date sau aplicațiile dvs., precum Slack și Google Drive — fără ca un dezvoltator să trebuiască să creeze un conector personalizat pentru fiecare conexiune în parte. Gândiți-vă la acesta ca la un port USB-C pentru IA. Anthropic a introdus MCP în 2024 și l-a transferat ulterior către Fundația Linux, iar de atunci a fost adoptat de OpenAI, Google și Microsoft, devenind unul dintre standardele cu cea mai rapidă răspândire din istoria recentă a IA.
„Mixture of Experts” (MoE) este o arhitectură de model care împarte o rețea neuronală în mai multe subrețele specializate mai mici, sau „experți”, și activează doar o mână dintre aceștia pentru orice sarcină dată. În loc să direcționeze fiecare solicitare prin întregul model — ca și cum ai apela la întreg biroul pentru fiecare întrebare — un model MoE dispune de un „router” încorporat care selectează exact specialiștii potriviți pentru sarcina respectivă. Acest lucru face posibilă construirea unor modele enorme care rămân relativ rapide și ieftine de rulat, deoarece doar o fracțiune din rețea lucrează în orice moment. Modelul Mixtral al Mistral AI este un exemplu binecunoscut; se consideră, de asemenea, că noile modele GPT ale OpenAI utilizează o versiune a acestei abordări, deși compania nu a confirmat niciodată acest lucru în mod oficial.
(Vezi: Rețea neuronală, învățare profundă)
O rețea neuronală se referă la structura algoritmică multistratificată care stă la baza învățării profunde — și, într-un sens mai larg, la întreaga explozie a instrumentelor de IA generativă care a urmat apariției modelelor lingvistice de mari dimensiuni.
Deși ideea de a se inspira din căile dens interconectate ale creierului uman ca structură de proiectare pentru algoritmi de procesare a datelor datează încă din anii 1940, abia apariția mult mai recentă a hardware-ului de procesare grafică (GPU-uri) — prin intermediul industriei jocurilor video — a dezvăluit cu adevărat potențialul acestei teorii. Aceste cipuri s-au dovedit a fi foarte potrivite pentru antrenarea algoritmilor cu mult mai multe straturi decât era posibil în epocile anterioare — permițând sistemelor de IA bazate pe rețele neuronale să atingă performanțe mult mai bune în numeroase domenii, inclusiv recunoașterea vocală, navigația autonomă și descoperirea de medicamente.
(Vezi: Model lingvistic de mari dimensiuni [LLM])
Un scenariu ipotetic de cel mai rău caz, în care un model raționează exclusiv pe baza reprezentărilor sale numerice interne, în loc să utilizeze un limbaj inteligibil pentru oameni, transformându-și astfel procesul de gândire într-o „cutie neagră” totală. Niciun model lansat pe piață nu funcționează astfel în prezent — OpenAI a declarat că modelul său modelul Astra (lansat în septembrie 2026 și remarcabil pentru utilizarea timpurie a tehnicii de raționament numită „recurență opacă”) își păstrează lanțul de gândire lizibil și a respins comparațiile cu „neuralese”. Însă cercetătorii din domeniul siguranței subliniază faptul că utilizarea de către Astra a recurenței opace — definiția acesteia se află chiar mai jos — ca un adevărat prim pas în această direcție, motiv pentru care termenul a câștigat rapid popularitate odată cu apariția articolelor despre lansarea modelului Astra.
Recurența opacă se referă la situația în care un model de IA repetă aceeași interogare prin straturile sale interne în mod ciclic, în loc să raționeze pas cu pas în limbaj simplu. Este mai eficientă — modelele mai mici pot depăși limitele lor, consumând mai puține resurse de calcul — dar lasă mult mai puține urme lizibile decât un lanț normal de gândire (acel comentariu în timp real pe care îl vedeți după ce solicitați ajutorul unui chatbot). Acest lucru îngrijorează cercetătorii din domeniul siguranței, deoarece aceste jurnale sunt un instrument cheie pentru depistarea comportamentelor necorespunzătoare — iar această tehnică ar putea îngreuna semnificativ această supraveghere.
(Vezi: Lanț de gândire)
Termenul „open source” se referă la software — sau, din ce în ce mai des, la modele de IA — al cărui cod sursă este pus la dispoziția publicului, pentru ca oricine să îl poată utiliza, inspecta sau modifica. În lumea IA, familia de modele Llama de la Meta este un exemplu proeminent; Linux este celebrul echivalent istoric în domeniul sistemelor de operare. Abordările open source permit cercetătorilor, dezvoltatorilor și companiilor din întreaga lume să construiască pe baza muncii celorlalți, accelerând progresul și permițând audituri independente de siguranță pe care sistemele închise nu le pot oferi cu ușurință. „Sursă închisă” înseamnă că codul este privat — poți folosi produsul, dar nu poți vedea cum funcționează, așa cum este cazul modelelor GPT ale OpenAI — o distincție care a devenit una dintre dezbaterile definitorii din industria IA.
Paralelizarea înseamnă a face mai multe lucruri în același timp, în loc să le faci unul după altul — ca și cum ai avea 10 angajați care lucrează simultan la diferite părți ale unui proiect, în loc ca un singur angajat să facă totul secvențial. În domeniul IA, paralelizarea este fundamentală atât pentru antrenare, cât și pentru inferență: GPU-urile moderne sunt proiectate special pentru a efectua mii de calcule în paralel, ceea ce reprezintă unul dintre principalele motive pentru care au devenit coloana vertebrală hardware a industriei. Pe măsură ce sistemele de IA devin tot mai complexe și modelele tot mai mari, capacitatea de a paraleliza activitatea pe mai multe cipuri și mai multe mașini a devenit unul dintre cei mai importanți factori în determinarea rapidității și a rentabilității cu care modelele pot fi construite și implementate. Cercetarea privind strategii mai bune de paralelizare este acum un domeniu de studiu de sine stătător.
„RAMageddon” este un termen nou și amuzant pentru o tendință deloc amuzantă care cuprinde industria tehnologică: o penurie tot mai mare de memorie cu acces aleatoriu (RAM), adică de cipuri RAM, care alimentează practic toate produsele tehnologice pe care le folosim în viața de zi cu zi. Pe măsură ce industria IA a înflorit, cele mai mari companii de tehnologie și laboratoarele de IA — toate concurând pentru a deține cea mai puternică și eficientă IA — achiziționează atât de multă memorie RAM pentru a-și alimenta centrele de date, încât nu mai rămâne prea mult pentru restul dintre noi. Iar acest blocaj în aprovizionare înseamnă că ceea ce mai rămâne devine din ce în ce mai scump.
Printre acestea se numără industrii precum cea a jocurilor video (unde marile companii au fost nevoite să majoreze prețurile consolelor deoarece este mai greu să găsească cipuri de memorie pentru dispozitivele lor), electronice de larg consum (unde lipsa memoriei ar putea provoca cea mai mare scădere a livrărilor de smartphone-uri din ultimul deceniu), precum și sectorul IT pentru întreprinderi (deoarece aceste companii nu pot obține suficientă memorie RAM pentru propriile centre de date). Se preconizează că creșterea prețurilor se va opri abia după ce se va încheia temuta penurie, dar, din păcate, nu există prea multe semne că acest lucru se va întâmpla în curând.
Aceasta este o denumire mai „tehnică” pentru aceeași metodă de bază ca și „recurența opacă” (rularea unei interogări prin straturile unui model de numeroase ori, în loc de raționament secvențial în limbaj). Mass-media folosește cele două termeni aproape interschimbabil, motiv pentru care îl includem aici, deși „adâncimea recurentă” este termenul tehnic, iar „recurența opacă” este formularea care subliniază problema de siguranță.
(A se vedea Recurență opacă, lanț de gândire.)
La fel ca AGI, autoîmbunătățirea recursivă reprezintă un prag care determină cât de inteligentă poate deveni IA și cât de puțin se poate baza pe oameni. În scenariul RSI, modelele de IA încep să se îmbunătățească singure, fără intervenție umană, ceea ce duce la o accelerare uriașă a capacităților și autonomiei. În unele interpretări, acesta ar fi un moment cataclismic asemănător singularității, un moment în care modelele de IA devin imune la intervenția din exterior. Dar RSI descrie și o capacitate de bază — poate un model de IA să-și proiecteze propriul succesor? — ceea ce le facilitează mult inginerilor încercarea de a-l construi. O serie de startup-uri recente din domeniul IA și-au propus să construiască modele care se perfecționează recursiv, dar majoritatea dintre ele resping implicațiile apocaliptice, prezentând RSI pur și simplu ca următoarea frontieră a cercetării.
Învățarea prin întărire este o metodă de antrenare a IA în care un sistem învață prin încercări și primește recompense pentru răspunsurile corecte — ca și cum ți-ai antrena animalul de companie iubit cu gustări, cu excepția faptului că „animalul de companie” în acest scenariu este o rețea neuronală, iar „gustarea” este un semnal matematic care indică succesul. Spre deosebire de învățarea supravegheată, în care un model este antrenat pe un set de date fix de exemple etichetate, învățarea prin întărire permite unui model să-și exploreze mediul, să întreprindă acțiuni și să-și actualizeze continuu comportamentul pe baza feedback-ului primit. Această abordare s-a dovedit a fi deosebit de eficientă pentru antrenarea IA în vederea jucării de jocuri, a controlului roboților, și, mai recent, pentru a îmbunătăți capacitatea de raționament a modelelor lingvistice de mari dimensiuni. Tehnici precum învățarea prin întărire pe baza feedback-ului uman (RLHF) sunt acum esențiale pentru modul în care laboratoarele de vârf din domeniul IA își ajustează modelele pentru a fi mai utile, mai precise și mai sigure.
În ceea ce privește comunicarea om-mașină, există câteva provocări evidente — oamenii comunică folosind limbajul uman, în timp ce programele de IA execută sarcini prin procese algoritmice complexe bazate pe date. Tokenurile acoperă această diferență: ele sunt elementele de bază ale comunicării om-IA, reprezentând segmente discrete de date care au fost procesate sau generate de un model lingvistic de mari dimensiuni (LLM). Acestea sunt create printr-un proces numit tokenizare, care descompune textul brut în unități mici pe care un model lingvistic le poate procesa, similar modului în care un compilator traduce limbajul uman în cod binar pe care un computer îl poate înțelege. În mediul corporativ, token-urile determină și costul — majoritatea companiilor de IA taxează utilizarea modelelor LLM pe bază de token, ceea ce înseamnă că, cu cât o companie utilizează mai multe, cu atât plătește mai mult.
Așadar, tokenurile sunt fragmente mici de text — adesea părți de cuvinte, mai degrabă decât cuvinte întregi — în care modelele lingvistice de IA împart limbajul înainte de a-l procesa; ele sunt aproximativ echivalente cu „cuvintele” în contextul înțelegerii sarcinilor de lucru ale IA. Debitul se referă la cantitatea care poate fi procesată într-o anumită perioadă de timp, astfel încât debitul de tokenuri este, în esență, o măsură a volumului de muncă AI pe care un sistem îl poate gestiona simultan. Un debit ridicat de tokenuri este un obiectiv cheie pentru echipele de infrastructură AI, deoarece determină numărul de utilizatori pe care un model îi poate deservi simultan și cât de repede primește fiecare dintre ei un răspuns. Cercetătorul în IA Andrej Karpathy a descris sentimentul de anxietate pe care îl simte atunci când abonamentele sale la servicii de IA rămân nefolosite — o senzație care îi amintește de cea pe care o avea în calitate de student la masterat, când echipamentele informatice scumpe nu erau utilizate la maximum — un sentiment care explică de ce maximizarea debitului de tokenuri a devenit o adevărată obsesie în acest domeniu.
Dezvoltarea sistemelor de IA bazate pe învățare automată implică un proces cunoscut sub numele de antrenare. În termeni simpli, aceasta se referă la introducerea datelor pentru ca modelul să poată învăța din tipare și să genereze rezultate utile. În esență, este procesul prin care sistemul răspunde la caracteristicile datelor, ceea ce îi permite să-și adapteze rezultatele către un obiectiv dorit — fie că este vorba de identificarea imaginilor cu pisici sau de generarea unui haiku la cerere.
Antrenarea poate fi costisitoare, deoarece necesită o mulțime de date de intrare, iar volumele necesare au înregistrat o tendință de creștere — motiv pentru care abordările hibride, precum ajustarea fină a unei IA bazate pe reguli cu date specifice, pot ajuta la gestionarea costurilor fără a porni de la zero.
[See: Inference]
O tehnică în care un model de IA antrenat anterior este utilizat ca punct de plecare pentru dezvoltarea unui nou model destinat unei sarcini diferite, dar de obicei conexe — permițând reaplicarea cunoștințelor dobândite în ciclurile de antrenare anterioare.
Învățarea prin transfer poate genera economii de eficiență prin scurtarea procesului de dezvoltare a modelului. De asemenea, poate fi utilă atunci când datele pentru sarcina pentru care se dezvoltă modelul sunt oarecum limitate. Totuși, este important de reținut că această abordare are limitări. Modelele care se bazează pe învățarea prin transfer pentru a dobândi capacități generalizate vor necesita probabil antrenare pe date suplimentare pentru a funcționa bine în domeniul lor de interes
(Vezi: Reglarea fină)
Pierderea de validare este o valoare numerică care indică cât de bine învață un model de IA în timpul antrenării — cu cât este mai mică, cu atât este mai bine. Cercetătorii o monitorizează îndeaproape ca pe un fel de fișă de evaluare în timp real, folosind-o pentru a decide când să oprească antrenamentul, când să ajusteze hiperparametrii sau dacă trebuie să investigheze o potențială problemă. Una dintre principalele preocupări pe care aceasta ajută la semnalarea ei este supraînvățarea, o situație în care un model memorează datele de antrenament în loc să învețe cu adevărat tiparele pe care le poate generaliza la situații noi. Gândiți-vă la asta ca la diferența dintre un elev care înțelege cu adevărat materia și unul care pur și simplu a memorat examenul de anul trecut — pierderea de validare ajută la a dezvălui în care dintre cele două categorii se încadrează modelul dumneavoastră.
Ponderile sunt esențiale pentru antrenarea IA, deoarece determină câtă importanță (sau pondere) se acordă diferitelor caracteristici (sau variabile de intrare) din datele utilizate pentru antrenarea sistemului — modelând astfel rezultatul modelului de IA.
Cu alte cuvinte, ponderile sunt parametri numerici care definesc ce este cel mai relevant într-un set de date pentru o anumită sarcină de antrenare. Ele își îndeplinesc funcția prin aplicarea operației de înmulțire asupra datelor de intrare. Antrenarea modelului începe de obicei cu ponderi alocate aleatoriu, dar pe măsură ce procesul avansează, ponderile se ajustează pe măsură ce modelul încearcă să ajungă la un rezultat care se potrivește mai bine cu ținta.
De exemplu, un model de IA pentru prezicerea prețurilor locuințelor, antrenat pe date istorice din domeniul imobiliar pentru o locație țintă, ar putea include ponderi pentru caracteristici precum numărul de dormitoare și băi, dacă o proprietate este independentă sau înșiruită, dacă dispune de parcare, garaj și așa mai departe.
În cele din urmă, ponderile pe care modelul le atribuie fiecăreia dintre aceste date de intrare reflectă cât de mult influențează acestea valoarea unei proprietăți, pe baza setului de date dat.
Acest articol este actualizat periodic cu informații noi.
Când efectuați o achiziție prin intermediul linkurilor din articolele noastre, este posibil să primim un mic comision. Acest lucru nu afectează independența noastră editorială.